如何让 AI 视频里的人物保持一致(实测经验)
本页更新记录
- — 发布:三类走样、人脸打码(Tiny Desk)、深度视频(Pick It Up 三次实测)、选图和多人规则。
- — 更正 Tiny Desk 归因(打码 + 提示词衣服那句);补充深度视频怎么做;视频封面;NVIDIA 研究链接;多条视频固定角色描述。
先看一条失败的视频。一张穿裙子的女生照片,一段舞蹈视频,模型是 Seedance 2 Mini(我们站上的视频模型之一)。开头是她,转了一圈回来,变成了另一个穿同一条裙子的女生。动作一点没错,视频却没法用,因为这类视频的意义就在于「跳舞的是我」。
我们每周都在做照片转视频的模板,听到最多的抱怨就是「不像我」。网上讲如何让 AI 视频人物保持一致的文章,给的基本是同一份清单:用参考图、重复描述、动作小一点。从零生成时这份清单够用,可一旦用上参考视频就不太管用了,而我们的失败大多出在这里。下面是我们改了什么,连同失败的那几次。
AI 视频的「人物一致性」到底指什么?
AI 视频的人物一致性其实包含四种不同的失败,每种的修法都不一样。把它们混在一起讲,是很多通用建议不管用的原因。下面每一行在后文都有单独一节。
| 问题 | 看到的现象 | 主要原因 |
|---|---|---|
| 单条视频里走样 | 转身、快速挥手、脸被挡之后就变脸 | 模型反复重画脸,画丢了 |
| 被参考视频带跑 | 脸介于你和原表演者之间;多人时衣服串到别人身上 | 原视频里的脸还在 |
| 照片信息不够 | 从第一帧起就不像 | 侧脸、墨镜、脸太小或太糊、合照 |
| 多条之间对不上 | 每条视频都像略微不同的人 | 每次换了照片、模型或设置 |
AI 视频为什么会中途变脸?
AI 视频中途变脸,是因为大动作逼着模型一遍遍重画脸,每重画一次都可能画丢。人转得越多、挥手越快、脸被挡得越久,模型要凭记忆重建的身份就越多。NVIDIA 的研究从模型内部看到了同样的取舍:视频模型里承载动作的那部分特征,同时也承载身份,动作推得越猛,身份越容易丢。
开头那条就是最典型的例子。Pick It Up 这支舞全是转身。用 Seedance 2 Mini,她面朝镜头时脸还稳,第一次转回来就崩了。快速手臂动作也一样:Cheba Man 舞里手臂不停在脸前交叉,很多模型恰恰在这些时刻把脸画糊或画歪。
- 按动作选模型。 同一张照片、同一段视频,Wan 3.0 每次转身都保住了她的脸,连耳环和项链都在;Seedance 2 Mini 没保住。转身多的舞,我们用 Wan(站上的另一个模型,Wan 3.0 Prime 是它的高画质档)。
- 在提示词里写明。 有快速动作时,加一句要求快速运动中脸保持稳定、清晰、不糊。
- 别用弱照片去扛大动作。 照片里的脸小或者软,每次转身后模型能用来重建的信息就少。
为什么用参考视频时,脸会被原视频带跑?
用参考视频时脸会被带跑,是因为原表演者的脸还在视频里,模型会把两张脸混在一起。结果是一张一半像你、一半像他的脸,看着「差一点是我」,比完全不像还难受。
人一多就更乱。我们做 Tiny Desk 时,四张参考照片放进一段乐队视频,图 2 的发型跑到了图 3 的人头上,前 4 次不是失败就是造型串了。
我们用两个办法把原视频里的身份拿掉:给脸打码,或者把视频换成深度视频。
办法一:给参考视频里的脸打码
给参考视频里每张脸打码或模糊,模型就只能从你的照片取脸,因为已经没有别的脸可以照着画了。身体、手势、运镜和房间都还看得清,动作和节奏照样能传过去。
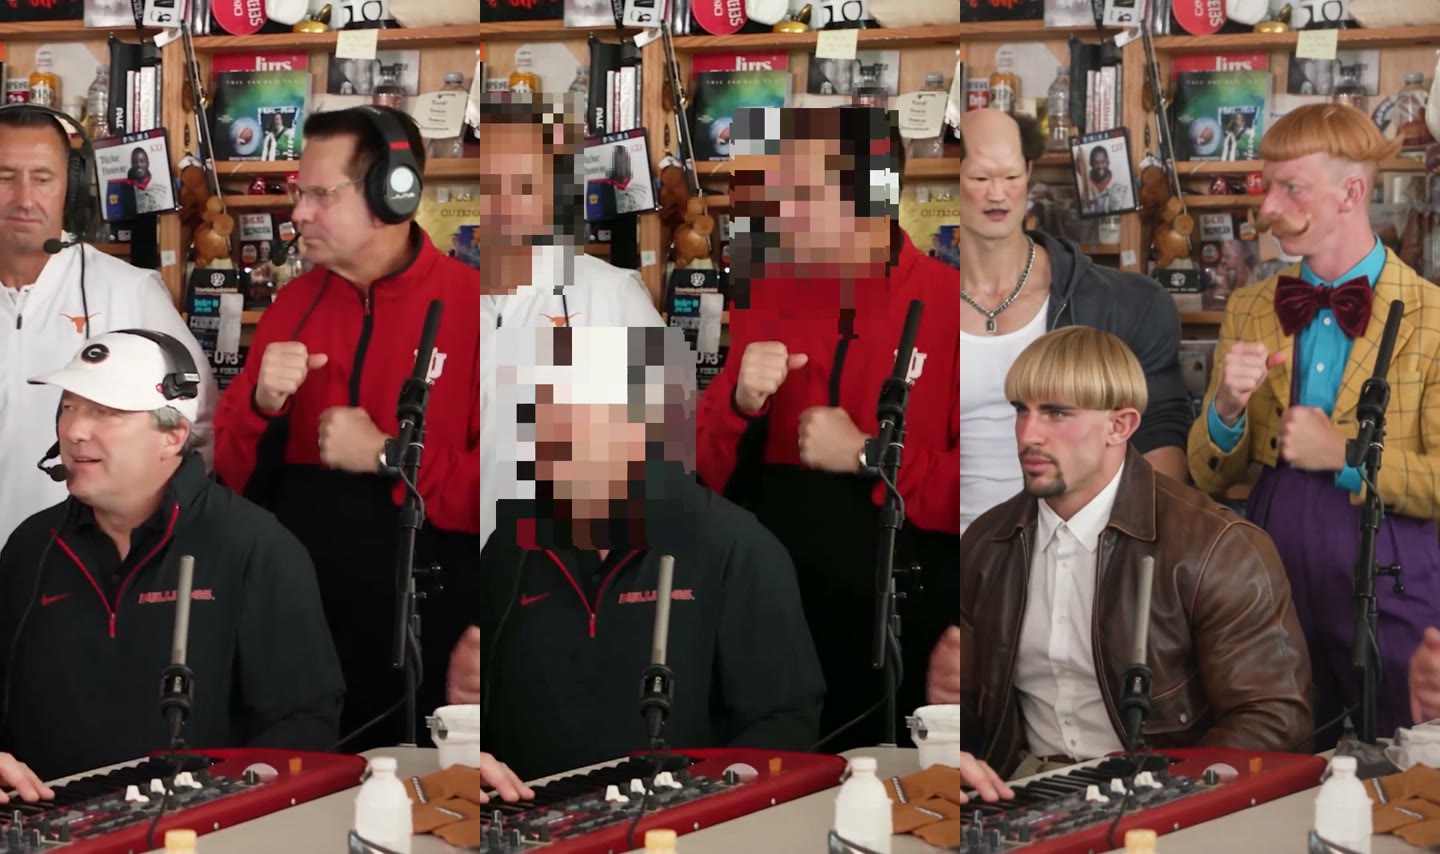
- 把视频剪到需要的那段(视频转视频模型一般最长 15 秒左右)。
- 用任何剪辑软件,整段给每张脸盖马赛克或模糊。不用很精细,盖住五官就行。
- 每个人一张参考照片,提示词里按位置指定谁换成谁。
- 写明原视频的衣服只用来区分谁是谁,发型和穿着都跟照片走。
| Tiny Desk 实测 | 数值 |
|---|---|
| 模型 | Wan 3.0 Prime |
| 输入 | 4 张照片 + 12 秒打码视频 |
| 次数 | 5 次:两处改动之前的 4 次失败或串造型(已退积分);第 5 次打码 + 提示词加了衣服那句,成功 |
| 积分 | 370 |
| 耗时 | 约 2 分钟 |
打码只是两处改动之一。另一处是下面这段提示词:只用衣服描述原来的人,让模型知道谁是谁,再明确说这些衣服不能留下来。有个教练的帽子一直冒出来,直到我们加上 "No one wears a hat." 才没了。现在只要原视频里有真人的脸,我们做模板时都会先打码。Bonito Bonito 宝宝舞就是一个:原视频里是一个真宝宝的脸,不打码的话,模型可能会往那个宝宝的长相靠,而不是你家宝宝。
The clothing described above is only for identifying who is who. Each new character must fully use the hairstyle, outfit, and look from their reference image. Do not keep any hats, clothes, or accessories from the original people. Clear, natural faces matching the reference images. Same background and props. Realistic, consistent identity, no extra people.
办法二:用深度视频,只留动作,不留身份
深度视频只留动作、不留身份:它把每一帧变成一张表示远近的灰度图,身形、姿势和节奏都在,脸、衣服、颜色和房间全没了。模型除了动作,没有别的可抄。
想自己做深度视频,可以把视频交给深度估计模型处理,比如 Depth Anything(ComfyUI 里有现成节点),它会为每一帧输出一张灰度深度图,再把这段深度视频作为动作参考,交给支持参考视频的模型。我们的模板已经做好了这一步,你只需要加一张照片。
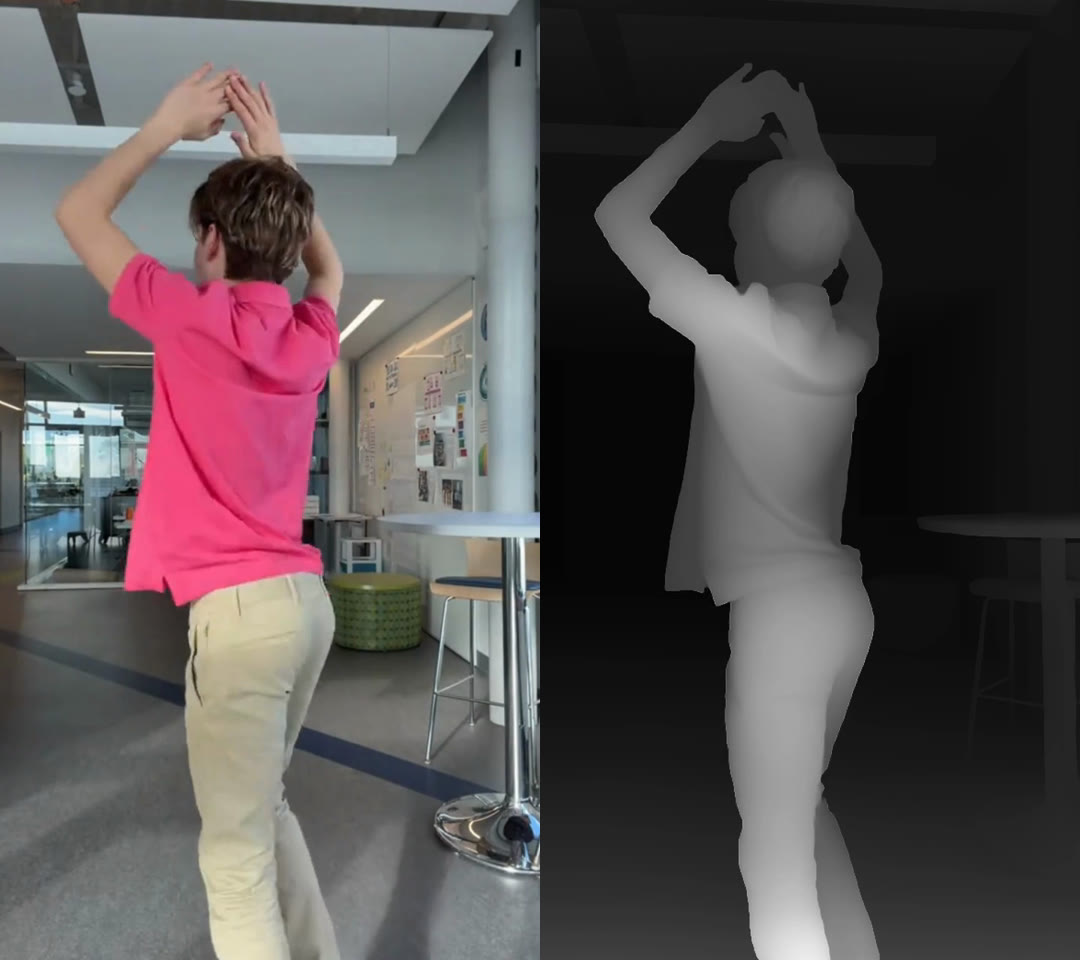
但这不等于一次就成。把原身份拿掉之后,会出现一个新的空缺。我们做 Pick It Up Dance 模板时踩到了。同一张照片、同一段深度视频,跑了三次:
第 1 次 · Seedance 2 Mini:脸走样
第 2 次 · Wan 3.0:脸保住了,背景丢了
第 3 次 · Wan 3.0 + 分工提示词:成功
第 1 次:Seedance 2 Mini,脸走样了
就是文章开头那条。舞步对,转完第一圈脸就丢了,还多出一个她照片里根本没有的明亮大厅。深度视频能拿掉抢戏的那张脸,但拦不住模型在快速转身时自己把脸画丢。
第 2 次:Wan 3.0,脸保住了,地方没保住
Wan 3.0 每次转身都保住了她的脸、耳环和金色项链。但照片里她身后那面活动背景墙,第一帧就没了,换成一个黑漆漆的空舞室。深度视频里没有能用的背景,短提示词又只讲了跳舞,模型就用它最熟悉的舞蹈场景把空缺填上了。
第 3 次:Wan 3.0,提示词给每个输入分好工
The person in the reference photo performs the dance from the reference video, matching every movement, rhythm and body orientation frame by frame. Use the reference video only for motion and timing. Take the person, the background, the scene and the lighting from the reference photo. Do not create a new stage, studio or dark backdrop. Keep the location from the photo as the background for the whole video, with the same architecture, colors, signs, text and logos, and the same lighting. When the person turns or moves, fill in any newly revealed background so it matches the same place. Any other people in the background stay in place or keep moving naturally; they do not dance. Keep the person's face, hairstyle, body shape and outfit from the photo. If the photo does not show the full body, complete the legs and shoes naturally in the same style as the visible outfit. Locked, stable camera. No flicker, no warping of the background, no added text or watermark.
背景墙连 logo 在内,12 秒一直都在。这次花了 240 积分(约 $2.22),大约 4 分钟。从这三次里我们总结出三条规则,现在每个模板的提示词都按这个写:
- 每个输入只管一件事。 视频管动作和节奏,照片管人、地方和光线。就用这几个词直接写出来。
- 把你担心的失败写出来。 一句「不要生成新的舞台、舞室或暗色背景」,比描述一大段背景管用。
- 告诉模型照片没拍到的地方怎么补。 转身时露出来的背景、被裁掉的腿。不说,模型就自己编。
打码还是深度视频,怎么选?
我们没有拿同一个模板两种办法都跑一遍,所以下面是从现有模板里总结的经验,不是对比实测的结论。只有一个主角、场景要用你照片里的,用深度视频,它连原视频的房间一起拿掉了。要保留原视频的场景、灯光和道具,或者有好几个人要各就各位,就给脸打码,因为深度图里站在同样远近的人很难区分。
| 人脸打码 | 深度视频 | |
|---|---|---|
| 模型还能从视频里看到什么 | 身体、衣服、房间、光线、运镜 | 只有姿势、远近和节奏 |
| 场景来自 | 原视频 | 你的照片(要在提示词里写明) |
| 适合 | 多人、标志性场景(Tiny Desk) | 一个人在你自己的地方跳(Pick It Up) |
| 要注意 | 原视频的衣服串到你们身上 | 提示词没写背景时,会冒出一个通用舞室 |
什么照片会让 AI 视频不像你?
脸小、模糊、侧过去或者被挡住的照片,会让 AI 视频不像你,因为大部分五官都得靠模型去猜。上面所有办法,前提都是照片给的信息够用。
| 好用 | 不好用 |
|---|---|
| 脸朝镜头,看得到眼睛 | 侧脸、低头 |
| 清晰、自然光 | 模糊、重滤镜、夜里拍的 |
| 照片里只有一个人 | 合照(哪个是你?) |
| 脸完整露出来 | 墨镜、帽檐压眼、手挡脸 |
| 跳舞类用半身或全身照 | 视频要全身时只给一张大头特写 |
穿着和发型也跟照片走。我们每个模板都这么写:照片里穿什么,视频里就穿什么;原表演者的衣服只用来告诉模型换的是哪个人。想在视频里穿球衣或婚纱,就穿着它拍照片。
一个 AI 视频里有好几个人,怎么不串脸?
想让同一个 AI 视频里的几个人不串脸,要用每一帧都看得到的东西告诉模型谁是谁,比如位置或道具,而不是衣服。衣服是人最先注意到的,但在快速、模糊的画面里,它是很弱的信号。
我们做竖中指扣篮时,两个人都穿黑裤子,画面大半是运动模糊,卫衣一半时间在空中乱飞。前两次用衣服描述两个人,两次都换反了。成功的那次改成用球来描述:谁运球扣篮,谁防守。球每一帧都在。
- 按位置(左、中、右)或者按在做什么来指定人。
- 每个人一张照片,能的话衣服差别明显一点。
- 把原视频的脸打码,没有东西可以混。
多条 AI 视频之间,怎么保持同一张脸?
多条 AI 视频之间要保持同一张脸,就每条都用同一张照片、同一个模型、同样的设置,只改动作。多条之间不一致,大多是因为一次改了两三样东西。
- 每个角色固定一张主照片,每条都用它。
- 每条提示词开头都放同一段简短的角色描述(年龄、发型、穿着),一字不改。
- 整个项目用同一个模型,换个模型画出来的脸就不一样。
- 一个镜头要接上一个镜头时,把 A 条的最后一帧当 B 条的第一帧。我们的照片转视频支持首帧和可选的尾帧。
- 每条都短一点。视频越短,转身越少,丢脸的机会就越少。
生成前的检查清单
- ☐ 每张照片一个人,脸朝镜头,清晰,不戴墨镜
- ☐ 照片里穿的就是你想在视频里穿的
- ☐ 用参考视频时:原视频的脸已打码,或已转成深度视频
- ☐ 提示词写明:视频管动作和节奏,照片管人、地方和光线
- ☐ 提示词写出你担心的失败(新舞室、人物换反、快动作时脸糊)
- ☐ 转身多?选能在动作中保住脸的模型(我们的实测是 Wan 3.0)
常见问题
AI 视频能做到人物完全一致吗?
目前没有哪个 AI 视频模型能保证人物完全一致。照片好、视频里没有抢戏的脸、提示词写清楚,我们的模板大多数时候能让脸从头到尾保持住,但快速转圈和脸被挡住时仍然可能崩。
为什么我一转身,AI 视频就不像我了?
转身后再转回来,模型要从头重画你的脸,有的模型会画丢。我们的 Pick It Up 实测里,Seedance 2 Mini 转完第一圈就丢了脸,Wan 3.0 保住了。清晰的正脸照也能给模型更多重建的依据。
该给脸打码,还是用深度视频?
想保留参考视频的场景、或者有好几个人时,给脸打码;只有一个人、背景要用你照片里的,用深度视频。这是从我们的模板里总结的经验,不是同一段视频的对比实测。
戴墨镜的照片、合照能用吗?
戴墨镜的照片或合照,做出来通常不像你。墨镜挡住了眼睛,合照里模型不知道该用哪个人。裁成一个人,换一张看得到眼睛的照片。
哪个 AI 模型最能保持人脸一致?
在我们转身多的实测里,Wan 3.0 比 Seedance 2 Mini 更能保持人脸一致;Seedance 2 Mini 更便宜,但转一圈就丢了脸。我们只比较在同样输入上真正跑过的模型。
生成失败扣积分吗?
在 AI Photo Animator 上生成失败不扣积分,会自动退回。如果成片不像你,先换一张更清晰的正脸照再试。